Von klassischem zu quantenbasiertem maschinellem Lernen
Eine praxisnahe Einführung in klassische neuronale Netze, Quanten-Maschinelles-Lernen und hybride Quantennetzwerke auf Basis parametrisierter Quantenschaltungen.
Von klassischem maschinellen Lernen zu Quantum Machine Learning
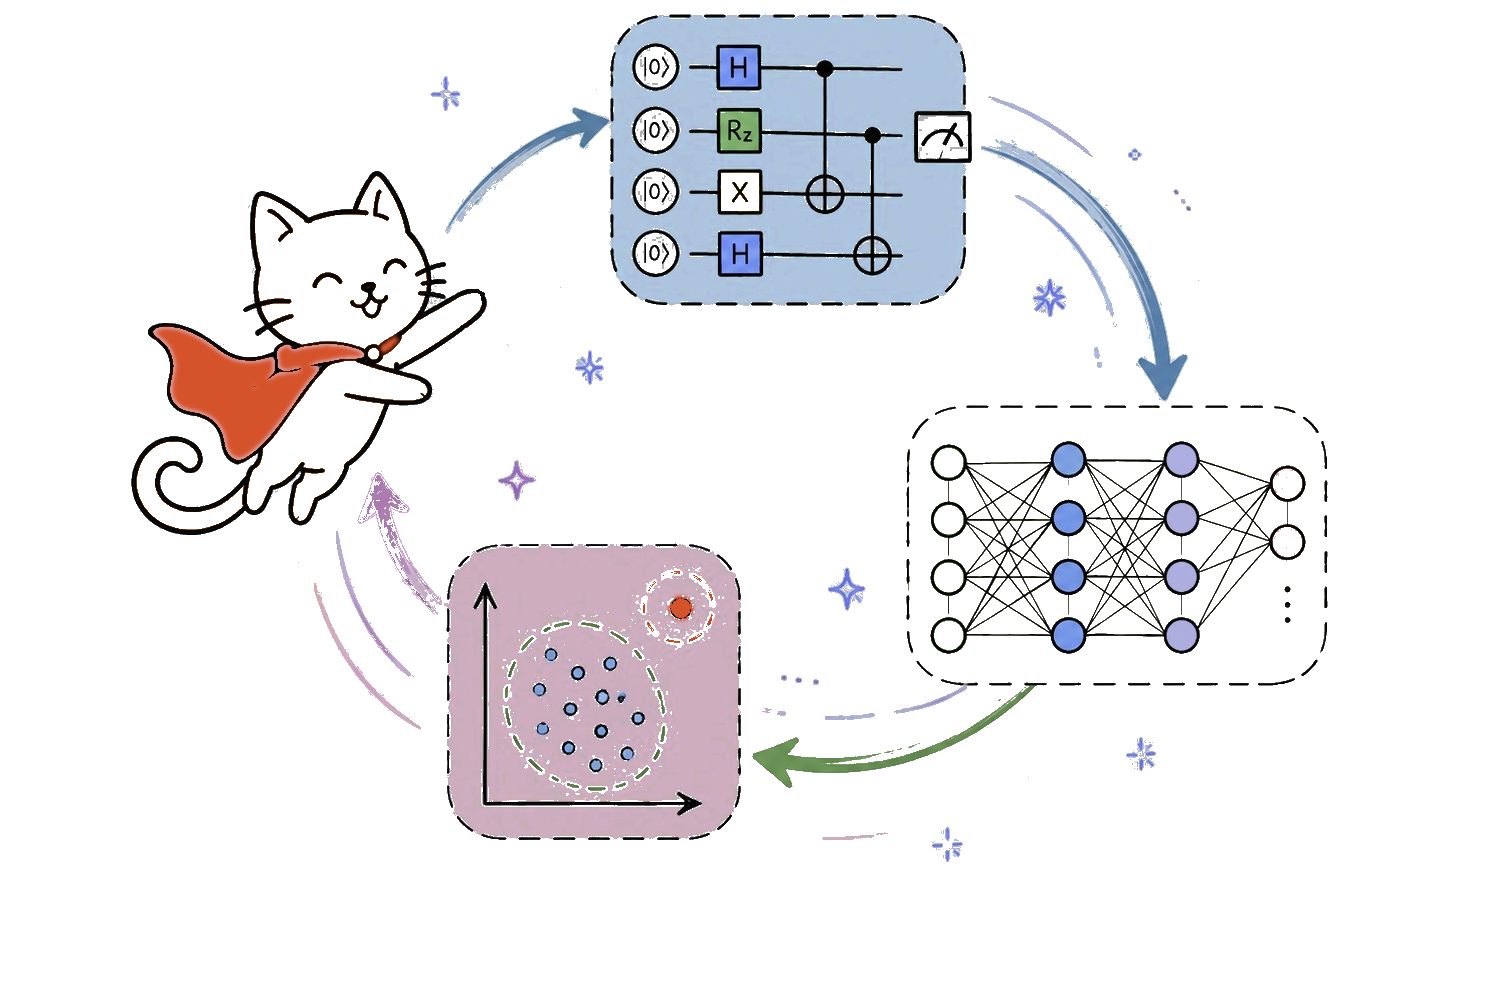
Maschinelles Lernen wird häufig für Klassifikation, Vorhersage, Mustererkennung und Anomalieerkennung eingesetzt [1,2]. Quantum Machine Learning, meist als QML abgekürzt, untersucht, ob Quantencomputer nützliche Komponenten zu solchen Lernabläufen beitragen können.
Die Antwort ist differenzierter als die Aussage „Quantenmodelle sind besser“. Bei vielen kleinen Aufgaben mit klassischen Daten bleiben gut gewählte klassische Modelle äußerst konkurrenzfähig. Das Ergebnis eines Vergleichs kann zudem stark von der Datenvorverarbeitung, der Modellauswahl und der Abstimmung der Hyperparameter abhängen [3]. Deshalb wird QML für kurzfristig realisierbare Anwendungen häufig in Form hybrider quantenklassischer Workflows untersucht. Dabei übernimmt eine Quantenschaltung einen Teil der Berechnung, während klassische Hardware die umgebende Datenverarbeitung und Optimierung ausführt [4,5].
Dieser Beitrag stellt den grundlegenden Machine-Learning-Workflow vor, erklärt, an welcher Stelle eine Quantenschaltung eingebunden werden kann, und gibt einen Überblick über die wichtigsten Ansätze im QML. Ein nachfolgender Beitrag konzentriert sich speziell auf quantum neuronale Netze auf Basis parametrisierter Quantenschaltungen.
Klassisches maschinelles Lernen kurz erklärt
Auf einer grundlegenden Ebene geht es beim maschinellen Lernen darum, nützliche Muster aus Daten zu lernen [2].
Ein typischer Workflow für überwachtes Lernen lässt sich folgendermaßen zusammenfassen:
Daten → Modell → Vorhersage → Verlustfunktion → Optimierer → aktualisiertes Modell
Die wichtigsten Bestandteile sind:
- Eingabedaten: numerische Merkmale, die jedes Datenbeispiel beschreiben.
- Modell: eine Funktion mit trainierbaren Parametern.
- Vorhersage: die Ausgabe des Modells für eine Eingabe.
- Verlustfunktion: ein Maß für den Vorhersagefehler.
- Optimierer: ein Algorithmus, der die Modellparameter aktualisiert.
- Auswertung: ein abschließender Test mit Daten, die nicht direkt für das Training verwendet wurden.
Ein binärer Klassifikator erhält beispielsweise einen Eingabevektor und sagt voraus, ob dieser zur Klasse 0 oder zur Klasse 1 gehört.
Ein neuronales Netz ist eine mögliche Modellfamilie. Seine Schichten kombinieren Eingabewerte mithilfe trainierbarer Gewichte und Bias-Terme:
$$ z = Wx + b, $$
wobei $x$ die Eingabe bezeichnet, $W$ die Gewichte enthält und $b$ die Bias-Terme.
Das Ergebnis wird anschließend durch eine nichtlineare Aktivierungsfunktion wie ReLU, Sigmoid oder tanh geleitet. Diese Nichtlinearitäten ermöglichen es einem neuronalen Netz, Zusammenhänge darzustellen, die durch das bloße Hintereinanderschalten linearer Transformationen nicht gelernt werden könnten [6,7].
Während des Trainings erzeugt das Modell eine Vorhersage, vergleicht sie mit dem korrekten Zielwert und aktualisiert seine Parameter, um den Fehler zu verringern.
Ein Machine-Learning-Modell lernt eine Abbildung von Eingaben auf Ausgaben, indem es trainierbare Parameter anpasst.
Warum klassische Baselines wichtig sind
Ein Modell ist nicht automatisch nützlich, nur weil es eine Quantenschaltung enthält. Es muss weiterhin mit klassischen Methoden verglichen werden, die dieselbe Aufgabe unter vergleichbaren Bedingungen lösen.
Dies ist insbesondere bei kleinen Tutorial-Datensätzen wichtig. Logistische Regression, Support-Vector-Maschinen, baumbasierte Modelle und kleine neuronale Netze können bereits sehr gute Ergebnisse erzielen. Eine Benchmark-Studie von Bowles, Ahmed und Schuld verglich zwölf verbreitete QML-Modelle auf 160 Datensätzen zur binären Klassifikation und kam zu dem Ergebnis, dass klassische Standardmodelle bei den untersuchten kleinen Aufgaben im Allgemeinen besser abschnitten [3].
Ein sorgfältig aufgebautes QML-Experiment sollte daher folgende Fragen stellen:
- Welche Leistung erreicht eine einfache klassische Baseline?
- Sind Datensatzaufteilung und Vorverarbeitung identisch?
- Wurden beide Modellfamilien fair abgestimmt?
- Welche Bewertungsmetrik ist für die Aufgabe geeignet?
- Fügt die Quantenkomponente einen nützlichen Modellierungsbeitrag hinzu oder lediglich zusätzliche Komplexität?
Ein Tutorial muss keinen Quantenvorteil demonstrieren. Sein Ziel kann stattdessen darin bestehen, die Architektur, den Trainingsablauf, den Messprozess und die praktischen Einschränkungen eines hybriden Modells zu erklären.
Was ist Quantum Machine Learning?
Quantum Machine Learning verbindet Konzepte des Quantencomputings mit Methoden des maschinellen Lernens [4].
In vielen QML-Anwendungen bleiben die Eingabedaten klassisch. Numerische Merkmale werden in einen Quantenzustand codiert oder als Parameter datenabhängiger Quantengatter verwendet. Eine Quantenschaltung kann anschließend als Merkmalsabbildung, Ähnlichkeitsschätzer, trainierbares Modell oder als andere Komponente eines Lernalgorithmus dienen.
Ein vereinfachter Vergleich sieht folgendermaßen aus:
Klassisches ML:
Eingabemerkmale → klassisches Modell → Vorhersage

Quantum ML:
Eingabemerkmale → Quantencodierung → Quantenschaltung → Messung → klassische Ausgabe

Eine Quantenschaltung stellt ihren Quantenzustand nicht direkt als gewöhnlichen numerischen Merkmalsvektor bereit. Stattdessen werden klassische Informationen durch Messungen extrahiert, beispielsweise als Bitstring-Stichproben oder geschätzte Erwartungswerte.
Für ein parametrisiertes Quantenmodell kann der Ablauf beispielsweise so aussehen:
Eingabe x
   ↓
Datencodierung
   ↓
Quantenschaltung U(x, θ)
   ↓
Messung
   ↓
Messstatistiken
   ↓
numerische Modellausgabe
Auf Quantenhardware wird ein Erwartungswert im Allgemeinen statistisch aus wiederholten Messergebnissen geschätzt.
Wichtige Ansätze im Quantum Machine Learning
QML ist ein breites Forschungsgebiet, dessen Kategorien sich häufig überschneiden. Vier oft diskutierte Ansätze sind variationelle Quantenalgorithmen, quantum neuronale Netze, Quanten-Kernelmethoden und quanteninspiriertes maschinelles Lernen.
Die ersten beiden Ansätze verwenden typischerweise trainierbare Schaltungsparameter, die in einer iterativen quantenklassischen Optimierungsschleife aktualisiert werden. Standardmäßige Quanten-Kernelmethoden verwenden dagegen üblicherweise eine feste Quanten-Merkmalsabbildung und trainieren das daraus entstehende Kernelmodell klassisch.
Variationelle Quantenalgorithmen
Variationelle Quantenalgorithmen kombinieren eine parametrisierte Quantenschaltung (PQC) mit einem klassischen Optimierer [5].
Anfangsparameter
   ↓
parametrisierte Quantenschaltung
   ↓
Messung
   ↓
Wert der Zielfunktion
   ↓
klassischer Optimierer
   ↓
aktualisierte Schaltungsparameter
   ↺
Die Schaltung enthält anpassbare Parameter, beispielsweise Rotationswinkel. Nachdem die Schaltung ausgeführt und gemessen wurde, aktualisiert ein klassischer Optimierer diese Parameter, um eine Zielfunktion zu minimieren.
Zu den Beispielen gehören der Variational Quantum Eigensolver (VQE), QAOA und variationelle Quantenklassifikatoren [8,9].
Dieses hybride Muster ist nicht auf maschinelles Lernen beschränkt. IBM, Cleveland Clinic und RIKEN kombinierten beispielsweise kürzlich parametrisierte Quantenschaltungen mit klassischen Supercomputing-Ressourcen in einem umfangreichen Chemie-Workflow [10]. Die Studie zeigte keinen eindeutigen Quantenvorteil, veranschaulichte jedoch, wie Quanten- und klassische Ressourcen in wissenschaftlichen Berechnungen integriert werden können.
Quantum neuronale Netze
Quantum neuronale Netze sind trainierbare Quantenmodelle, die von Konzepten neuronaler Netze inspiriert sind. Im heutigen QML bezeichnet der Begriff häufig Modelle, die aus parametrisierten Quantenschaltungen aufgebaut sind [12,13].
klassische Eingabedaten
   ↓
Quantencodierung
   ↓
parametrisierte Quantenschaltung
   ↓
Messung
   ↓
Vorhersage und Verlustfunktion
   ↓
klassischer Optimierer
   ↓
aktualisierte Modellparameter
   ↺
Die klassischen Eingabedaten werden durch datenabhängige Gatter in einen Quantenzustand codiert. Die trainierbare Schaltung transformiert anschließend diesen Zustand, während Messungen numerische Ausgaben liefern, aus denen Vorhersagen und eine Verlustfunktion berechnet werden können.
Wie andere variationelle Ansätze werden PQC-basierte QNNs normalerweise über eine iterative quantenklassische Optimierungsschleife trainiert.
Quanten-Kernelmethoden
Auch Quanten-Kernelmethoden beginnen damit, klassische Eingabedaten in einen Quantenzustand zu codieren [11]. In diesem Zusammenhang wird die Codierungsschaltung häufig als Quanten-Merkmalsabbildung bezeichnet, da sie die Daten in einen Quantenmerkmalsraum abbildet, in dem Ähnlichkeiten ausgewertet werden können.
klassische Eingabedaten
   ↓
Quantencodierung / Quanten-Merkmalsabbildung
   ↓
Schätzung der Ähnlichkeit von Quantenzuständen
   ↓
Kernelmatrix
   ↓
klassisches Kernelmodell
Der auf diese Weise quantenmechanisch berechnete Kernel kann von einem klassischen Algorithmus wie einer Support-Vector-Maschine verwendet werden.
Im Unterschied zu variationellen Quantenalgorithmen und PQC-basierten QNNs aktualisiert eine standardmäßige Quanten-Kernelmethode die Parameter der Quanten-Merkmalsabbildung normalerweise nicht in einer iterativen quantenklassischen Trainingsschleife. Stattdessen schätzt die Quantenschaltung Ähnlichkeiten zwischen codierten Datenpunkten, während das daraus entstehende Kernelmodell klassisch trainiert wird.
Es gibt auch trainierbare Varianten von Quantenkerneln. In diesem Beitrag wird jedoch die verbreitete Form mit einer festen Merkmalsabbildung betrachtet.
Quanteninspiriertes maschinelles Lernen
Quanteninspiriertes maschinelles Lernen verwendet Ideen aus der Beschreibung von Quantensystemen, läuft jedoch vollständig auf klassischer Hardware.
Tensor-Netzwerk-Modelle sind ein Beispiel dafür. Sie verwenden strukturierte mathematische Darstellungen, die ursprünglich für Quanten-Vielteilchensysteme entwickelt wurden, und wenden diese auf Aufgaben des maschinellen Lernens an [14]. Im Unterschied zu den zuvor beschriebenen Ansätzen benötigen sie keinen Quantenprozessor.
Fazit
Quantum Machine Learning ersetzt den vertrauten Machine-Learning-Workflow nicht vollständig. Es verändert vielmehr, an welcher Stelle und auf welche Weise ein Teil des Modells ausgewertet wird. Klassische Datenvorbereitung, Optimierung und Leistungsbewertung bleiben häufig unverzichtbar, während eine Quantenschaltung als Merkmalsabbildung, Kernelkomponente oder trainierbares Modell eingesetzt werden kann.
Die wichtigste Erkenntnis ist daher nicht, dass Quantenmodelle automatisch überlegen sind. Vielmehr stellen sie einen anderen rechnerischen Baustein bereit, dessen Nutzen anhand starker klassischer Baselines überprüft werden muss.
Der nächste Beitrag konzentriert sich auf eine besonders wichtige Modellfamilie: PQC-basierte quantum neuronale Netze. Er erklärt, wie sie sich von klassischen neuronalen Netzen unterscheiden, wie Messungen Teil der Modellausgabe werden und warum ihr Trainingsablauf normalerweise hybrid ist.
Referenzen
[1] Goodfellow, I., Bengio, Y. & Courville, A. Deep Learning. MIT Press (2016).
[2] Bishop, C. M. Pattern Recognition and Machine Learning. Springer (2006).
[3] Bowles, J., Ahmed, S. & Schuld, M. Better than classical? The subtle art of benchmarking quantum machine learning models. arXiv:2403.07059 (2024). https://doi.org/10.48550/arXiv.2403.07059
[4] Biamonte, J. et al. Quantum machine learning. Nature 549, 195–202 (2017). https://doi.org/10.1038/nature23474
[5] Cerezo, M. et al. Variational quantum algorithms. Nature Reviews Physics 3, 625–644 (2021). https://doi.org/10.1038/s42254-021-00348-9
[6] Cybenko, G. Approximation by superpositions of a sigmoidal function. Mathematics of Control, Signals and Systems 2, 303–314 (1989). https://doi.org/10.1007/BF02551274
[7] Hornik, K. Approximation capabilities of multilayer feedforward networks. Neural Networks 4, 251–257 (1991). https://doi.org/10.1016/0893-6080(91)90009-T
[8] Peruzzo, A. et al. A variational eigenvalue solver on a photonic quantum processor. Nature Communications 5, 4213 (2014). https://doi.org/10.1038/ncomms5213
[9] Farhi, E., Goldstone, J. & Gutmann, S. A quantum approximate optimization algorithm. arXiv:1411.4028 (2014). https://doi.org/10.48550/arXiv.1411.4028
[10] Letzter, R. Researchers use quantum-centric supercomputing to simulate 12,635-atom protein complex. IBM Quantum Computing Blog (5 May 2026). https://www.ibm.com/quantum/blog/cleveland-clinic-riken-chemistry
[11] Havlíček, V. et al. Supervised learning with quantum-enhanced feature spaces. Nature 567, 209–212 (2019). https://doi.org/10.1038/s41586-019-0980-2
[12] Benedetti, M., Lloyd, E., Sack, S. & Fiorentini, M. Parameterized quantum circuits as machine learning models. Quantum Science and Technology 4, 043001 (2019). https://doi.org/10.1088/2058-9565/ab4eb5
[13] Abbas, A. et al. The power of quantum neural networks. Nature Computational Science 1, 403–409 (2021). https://doi.org/10.1038/s43588-021-00084-1
[14] Stoudenmire, E. M. & Schwab, D. J. Supervised learning with tensor networks. Advances in Neural Information Processing Systems 29 (2016). https://proceedings.neurips.cc/paper/2016/hash/5314b9674c86e3f9d1ba25ef9bb32895-Abstract.html